Para lidar com áudio sobreposto (cross-talk) ao gerar cortes de mesacasts, você precisa isolar as faixas de voz no seu software de edição antes de enviar o vídeo para uma inteligência artificial. O uso de técnicas como audio ducking reduz automaticamente o volume do falante secundário durante interrupções, garantindo que o motor de transcrição da IA capture as palavras corretamente e aplique o enquadramento no falante ativo sem cortes de câmera erráticos.
Quando duas ou mais pessoas falam ao mesmo tempo, os modelos de Speech-to-Text (STT) enfrentam dificuldades severas. Eles tendem a mesclar as palavras de ambos os locutores, gerando legendas sem sentido, ou ignoram completamente uma das vozes. Além disso, como as ferramentas de clipagem usam o áudio para determinar quem está falando, o cross-talk pode fazer a câmera pular de um rosto para outro em frações de segundo.
Para evitar que você perca horas corrigindo legendas e reenquadrando vídeos manualmente, o fluxo de trabalho ideal exige um pré-processamento focado no isolamento das vozes.
O pré-requisito: Gravação em múltiplas faixas (Multitrack)
A correção eficaz do áudio sobreposto depende de como o podcast foi gravado. É fundamental que cada microfone seja gravado em um canal separado (multitrack). Se o seu mesacast foi gravado com todos os microfones mixados em uma única faixa estéreo, a separação manual torna-se um processo de redução de ruído complexo e muitas vezes destrutivo para a qualidade da voz.
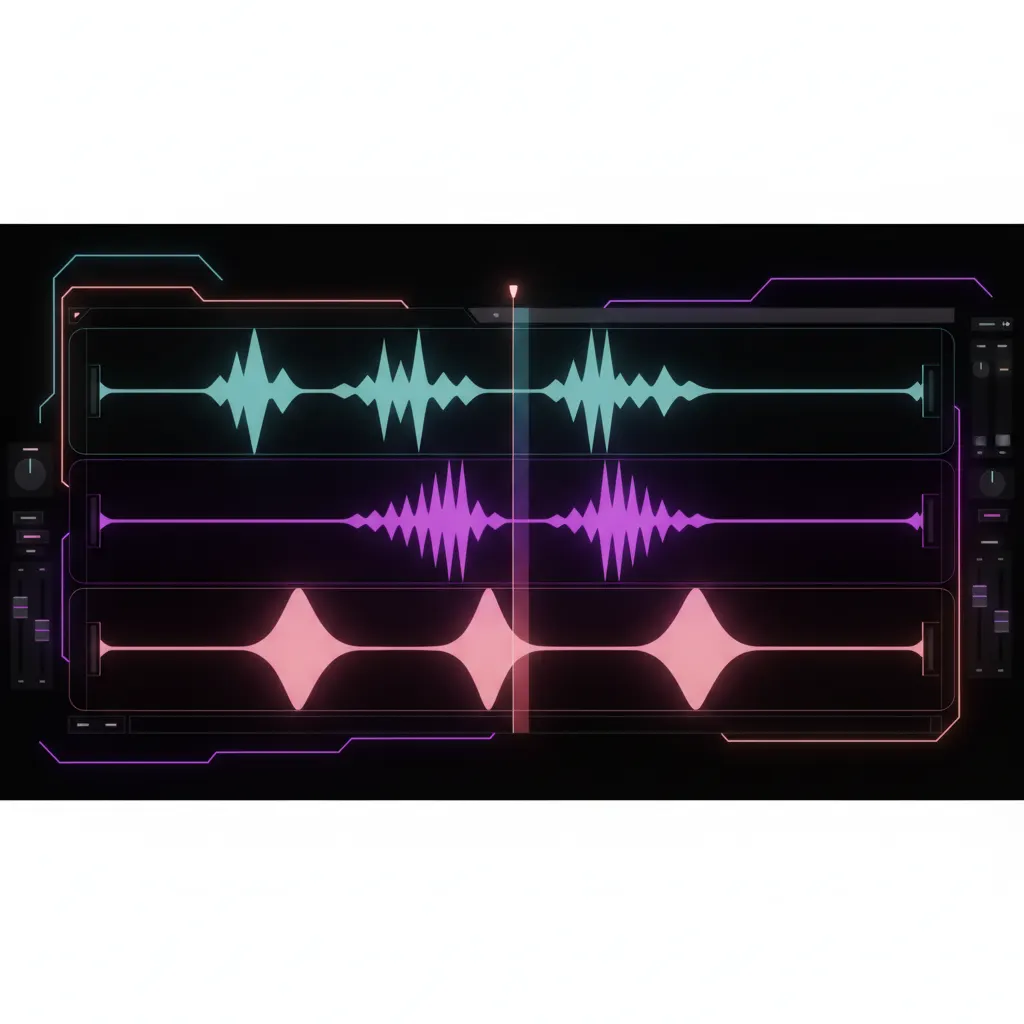
Com faixas separadas, você tem controle total sobre o volume de cada participante a qualquer momento. Isso permite que você identifique visualmente na waveform (onda sonora) os momentos em que dois convidados falam simultaneamente e decida qual voz deve ter prioridade na edição final.
Como usar o Audio Ducking para isolar vozes
O Audio Ducking é um recurso presente na maioria das Estações de Trabalho de Áudio Digital (DAWs) e Editores de Vídeo Não-Lineares (NLEs). Ele funciona diminuindo automaticamente o volume de uma faixa de áudio específica sempre que um sinal sonoro ultrapassa um determinado limite em outra faixa de controle.
Embora seja tradicionalmente usado para abaixar a música de fundo enquanto um narrador fala, essa técnica é altamente eficaz para gerenciar interrupções em mesacasts.
Aplicando Auto Duck no Audacity
O Audacity é um editor de áudio de código aberto amplamente utilizado para processamento de podcasts. Ele possui uma ferramenta nativa simples para lidar com a sobreposição.
O efeito Auto Duck reduz o volume de uma ou mais faixas selecionadas sempre que o volume de uma faixa de controle (colocada logo abaixo delas na linha do tempo) atinge um nível específico.
Para aplicar no seu mesacast:
- Importe as faixas de áudio separadas dos seus convidados.
- Posicione a faixa do falante principal (ou a faixa que deve ter prioridade no momento) logo abaixo da faixa do convidado que está interrompendo.
- Selecione a faixa do convidado que você deseja silenciar ou reduzir o volume.
- Acesse o menu de Efeitos e escolha Auto Duck.
- Ajuste o parâmetro Duck Amount (Quantidade de Redução). Para interrupções indesejadas que quebram a IA, uma redução de -18dB a -24dB geralmente é suficiente para que a ferramenta de transcrição ignore a voz de fundo.
- Configure o Maximum Pause para evitar que o volume suba e desça rapidamente se o falante principal fizer pequenas pausas respiratórias.
Aplicando Ducking no Final Cut Pro
Se você edita o vídeo completo antes de gerar os cortes, pode fazer esse tratamento diretamente no seu software de edição de vídeo. O Final Cut Pro oferece ferramentas automatizadas para isso.
O recurso Duck Audio no FCP permite que você destaque um clipe específico, reduzindo o volume de todos os outros clipes concorrentes na mesma posição da linha do tempo.
- Selecione o clipe de áudio ou vídeo da pessoa que está com a palavra.
- No Inspetor de Áudio, localize a seção Audio Ducking e clique em Apply (Aplicar).
- O Final Cut Pro reduzirá automaticamente o volume de todos os outros clipes de áudio que estiverem tocando simultaneamente.
- Você pode ajustar o controle deslizante Amount (Quantidade) para definir quão baixo o áudio secundário deve ficar.
Para situações em que a sobreposição ocorre apenas em uma palavra ou frase rápida, você pode usar a função do FCP para ajustar o volume automaticamente em uma área selecionada. Usando a ferramenta de Seleção de Intervalo (Range Selection), você marca apenas o trecho do cross-talk na faixa do convidado secundário e arrasta a linha de volume para baixo. O software cria os keyframes (quadros-chave) de entrada e saída automaticamente, suavizando a transição.
Impacto do áudio limpo nos layouts dinâmicos
Tratar o áudio não resolve apenas os erros de texto. Em podcasts com múltiplos convidados, o áudio limpo é o que dita o comportamento visual dos cortes automáticos.
Quando a IA recebe um arquivo onde apenas uma pessoa fala de cada vez (graças ao seu trabalho de ducking), ela consegue aplicar o enquadramento correto no modo de tela cheia. Por outro lado, se você decidir manter o cross-talk de forma intencional — por exemplo, durante uma discussão acalorada onde ambas as reações são importantes —, você deve deixar os volumes equilibrados. Como Usar Split-Screen com IA em Podcasts de Múltiplos Convidados explica que, ao detectar vozes simultâneas consistentes, algumas plataformas podem ser configuradas para adotar um layout de tela dividida (split-screen), mostrando os dois rostos ao mesmo tempo em vez de cortar a câmera erraticamente.
Saber como limpar o áudio do podcast automaticamente antes de gerar cortes é o passo que diferencia um corte profissional de um corte amador cheio de erros de sincronia.
Gerando os cortes finais após o tratamento
Depois de aplicar o ducking ou silenciar as faixas concorrentes nos momentos críticos de cross-talk, exporte o seu vídeo masterizado. Este arquivo consolidado agora possui um áudio claro e sequencial, perfeito para ser interpretado por algoritmos de inteligência artificial.
Com o arquivo preparado, você pode utilizar uma IA para cortes de podcast como o Real Oficial. A plataforma aceita vídeos de origem de até 10 horas de duração, o que permite subir o episódio completo do mesacast de uma só vez.
Como o áudio já foi tratado para evitar confusões de sobreposição, a seleção de cortes assistida por IA do Real Oficial poderá analisar com precisão os 18 sinais de potencial viral baseados no discurso. O sistema gerará legendas automáticas precisas com estilos derivados de composições do After Effects e aplicará o Real Prisma, um recurso de reenquadramento proprietário multimodal que adapta o vídeo perfeitamente para o formato 9:16.
Os planos do Real Oficial começam em R$ 59,90/mês, oferecendo 30 horas de processamento de vídeo, permitindo que você aplique edição em massa, exporte nativamente em 4K e até agende o conteúdo com até 30 dias de antecedência nas redes compatíveis.